在 AI 时代,数据正在成为重要的生产资料,而信息获取、整理与再利用能力,也逐渐成为提升效率的重要环节。
无论是竞品分析、知识库建设、自媒体内容创作,还是行业研究,一套高效的“内容采集与信息抓取”工具,都能够显著降低信息收集与整理的成本。
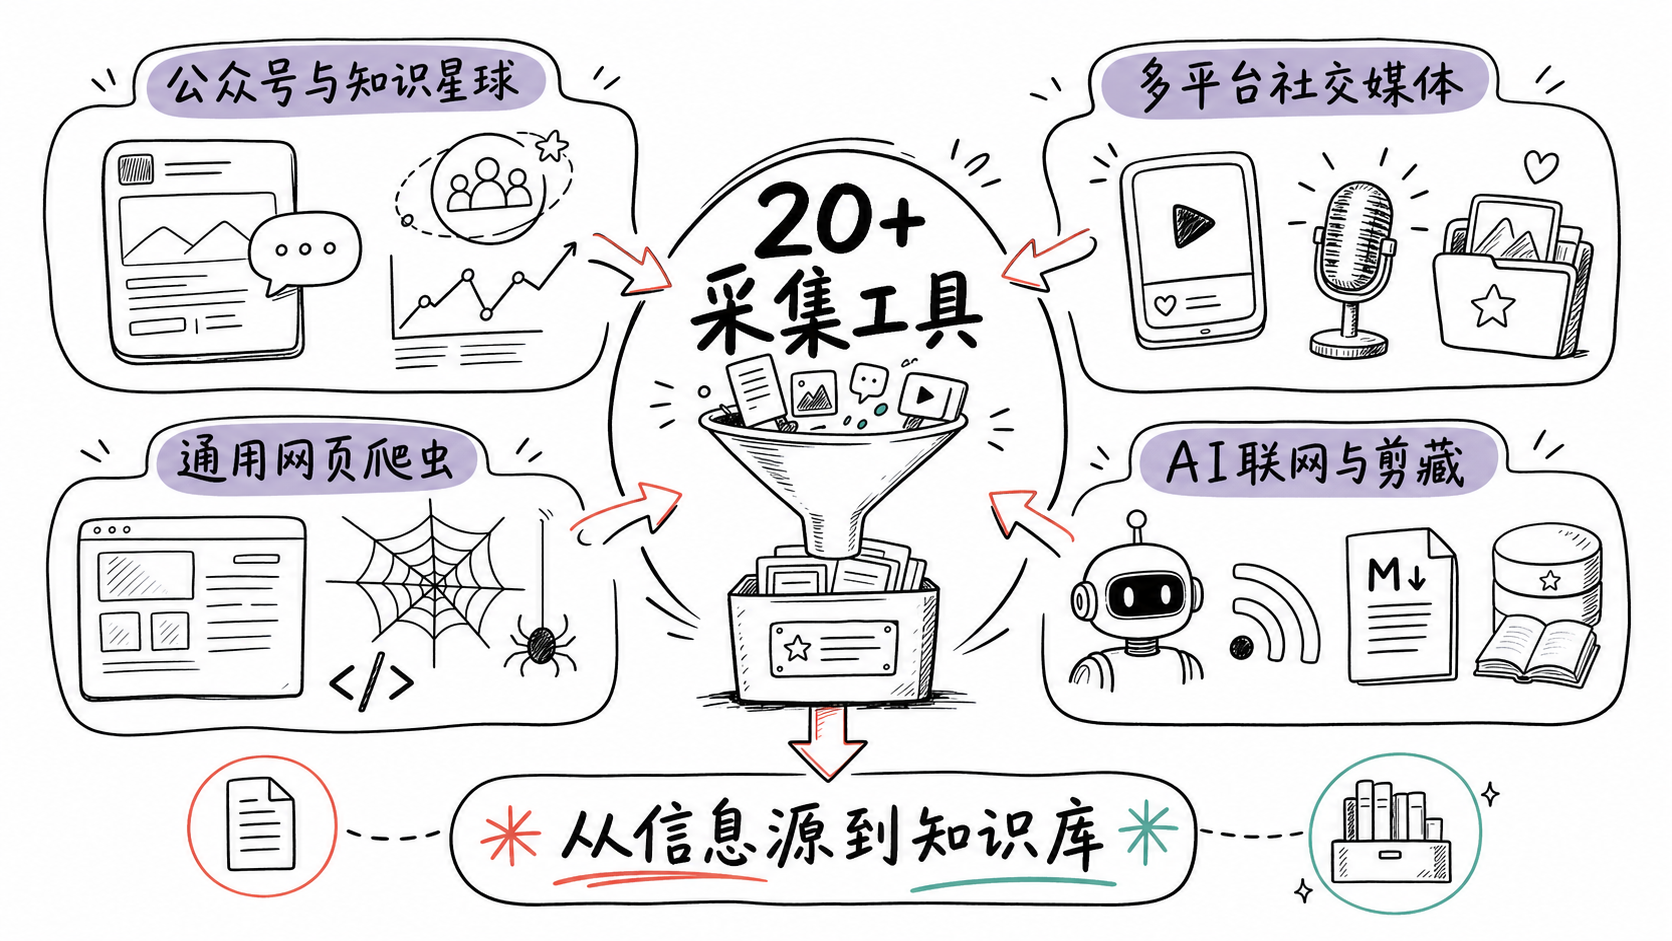
目前,围绕内容采集已经形成了较为丰富的开源工具生态。从微信公众号、知识星球等封闭内容平台,到抖音、B站、小红书、微博等社交媒体,再到通用网页爬虫、LLM 数据提取、AI 联网和智能剪藏,覆盖了从“发现信息”到“抓取内容”,再到“整理、分析和沉淀”的完整流程。
下面按照应用场景,将 20+ 个内容采集相关的开源项目与 Agent Skills 分为四大类别,方便不同需求的用户进行选择。
📱 一、微信公众号与知识星球采集
微信公众号和知识星球属于相对封闭的内容生态,传统方式下批量获取、整理和分析内容存在一定门槛。
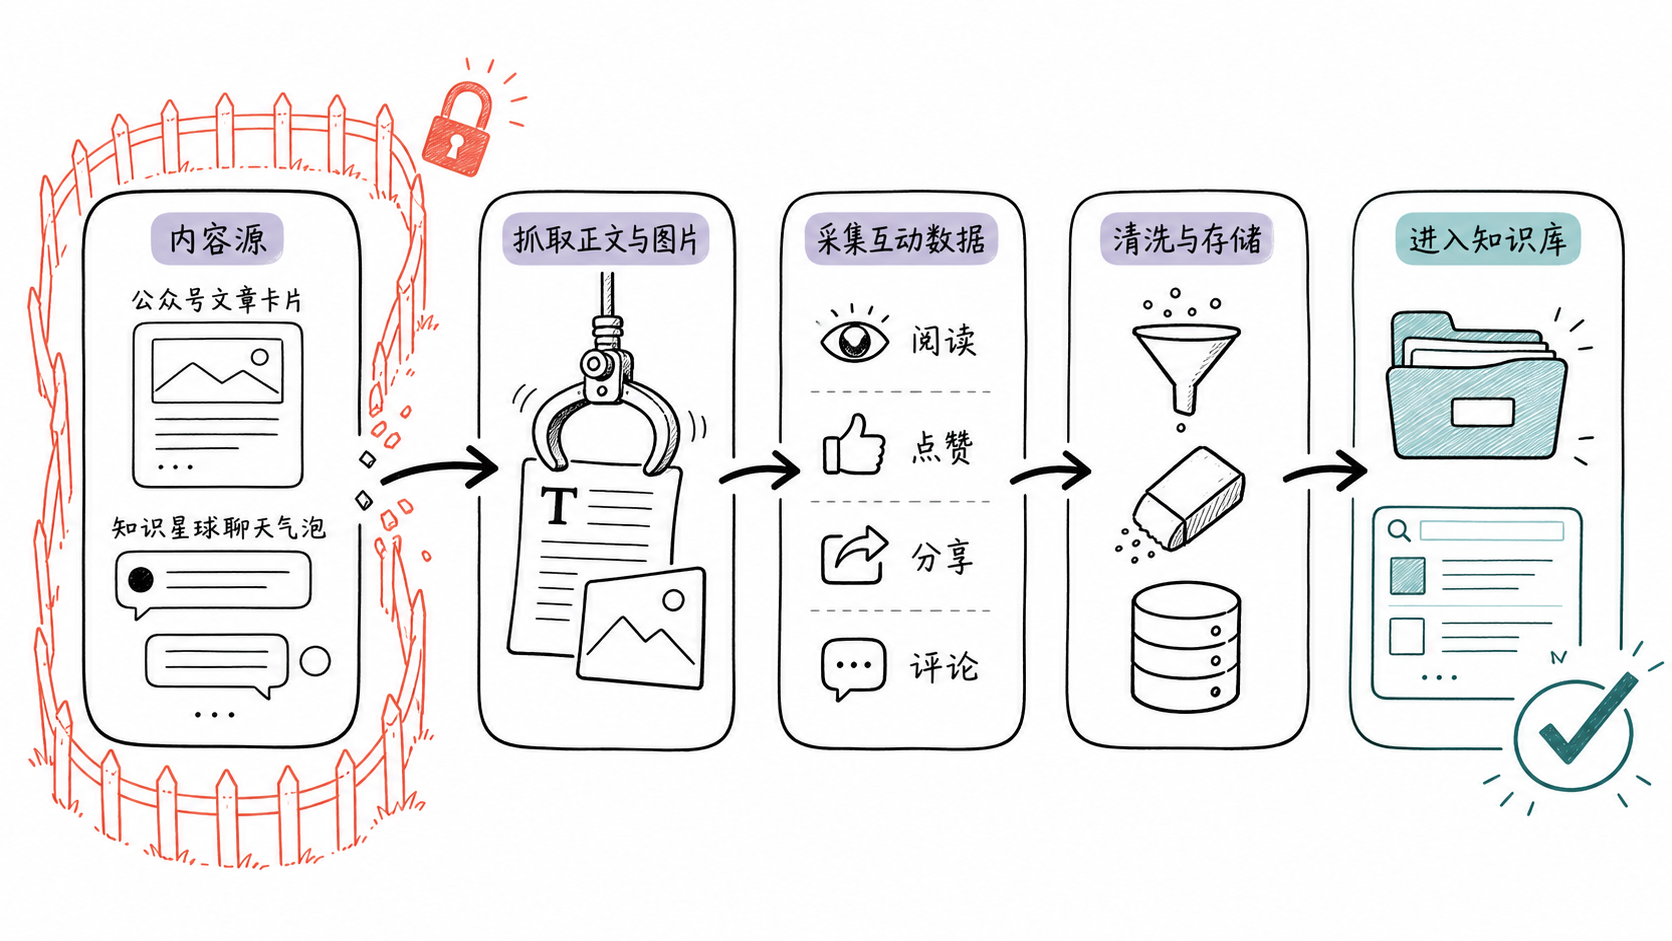
针对这一场景,目前已经出现了一批专门的数据采集工具,可以覆盖文章正文、互动数据、评论以及文件等不同类型的信息。
• wechat-pcspider
简介:
功能较为完整的微信公众号文章数据获取系统,支持自动化获取文章内容以及阅读量、点赞量、分享量、评论量等统计数据,同时支持获取留言区内容。
🔗 https://github.com/hjyl-cheng/wechat-pcspider
• wechat-download-api
简介:
开源的微信公众号文章获取与 RSS 订阅 API 服务,支持 IP 代理池和相关反风控机制,同时支持通过 MCP 接入各种 Agent 工具。
🔗 https://github.com/tmwgsicp/wechat-download-api
• wechat_articles_spider
简介:
专用于微信公众号文章采集的爬虫工具,适合与后续的数据清洗、处理和存储流程进行结合。
🔗 https://github.com/wnma3mz/wechat_articles_spider
• ZsxqCrawler
简介:
面向知识星球的可视化爬虫与文件下载工具,支持星球导入导出分享、话题采集以及文件批量下载等功能。
🔗 https://github.com/2977094657/ZsxqCrawler
• Hermes Agent 公众号抓取技能
简介:
通过在 Hermes Agent 中配置 Browser Use 或 CamoFox,可以构建微信公众号文章抓取流程,并将内容输出为 Markdown 或飞书文档。
整个流程覆盖正文与图片提取、内容清洗以及格式转换等环节,适合需要将公众号内容进一步沉淀到知识库中的场景。
🌐 二、多平台与社交媒体内容抓取
随着内容平台不断增加,信息采集也逐渐从单一平台扩展到多平台同步。
抖音、B站、小红书、微博、X、YouTube、Reddit 等平台拥有大量不同形式的信息资源,因此跨平台采集、统一整理和内容备份成为新的需求。
• chubbyskills
简介:
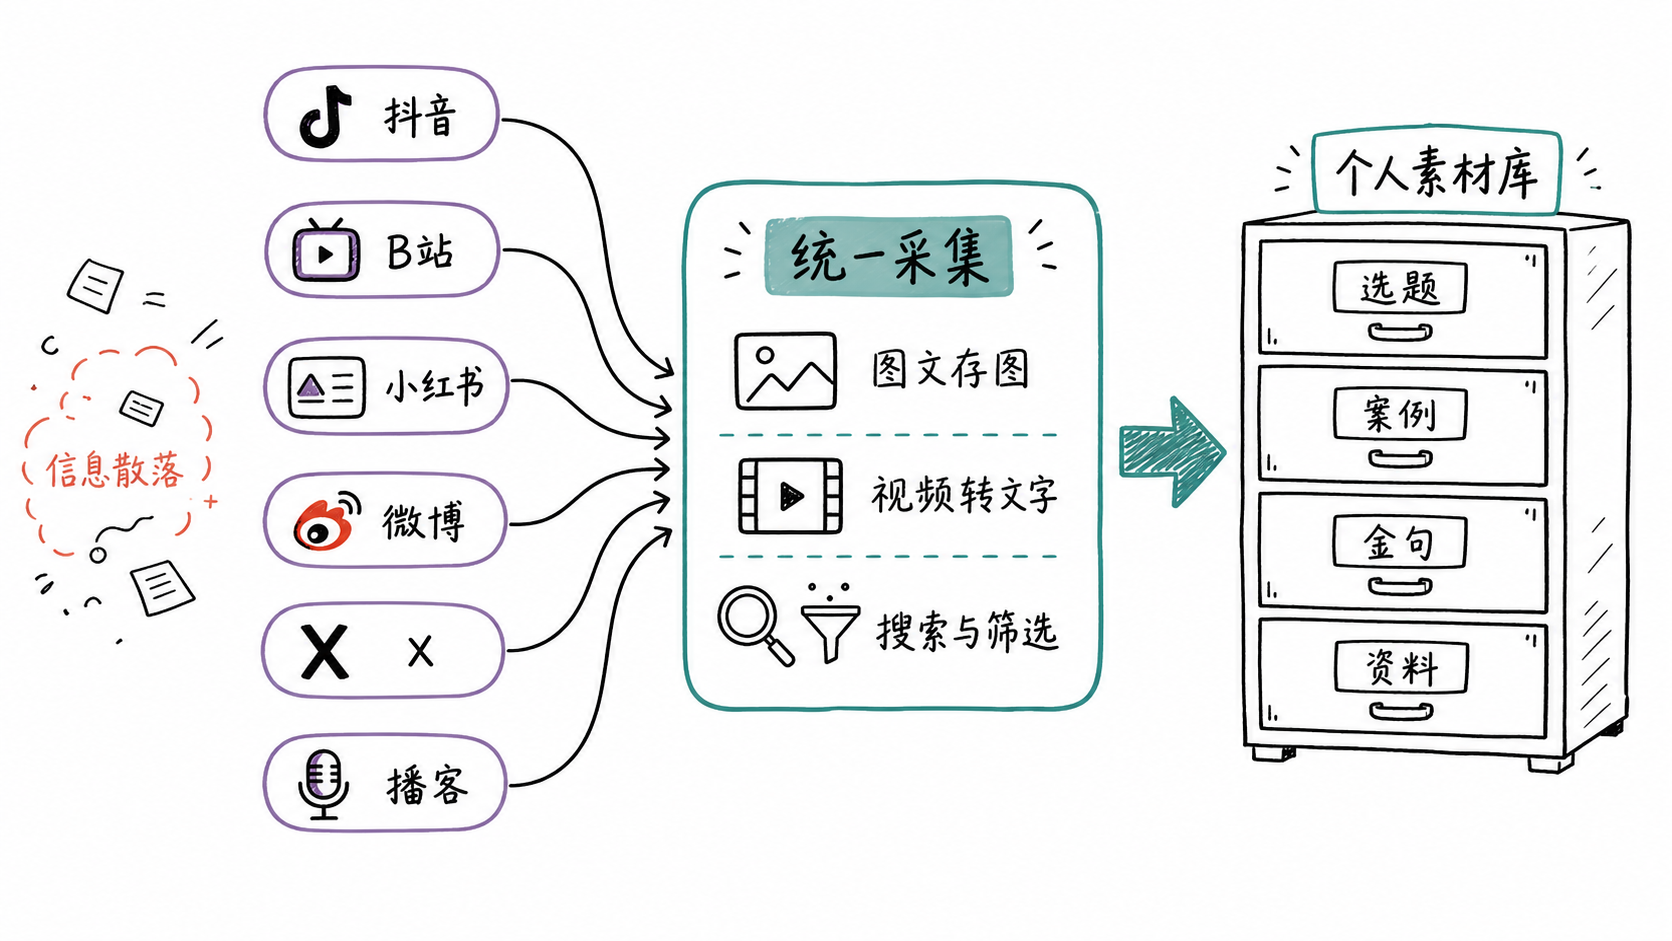
面向中文互联网内容采集的 AI Skill 集合,共包含 13 个 Skill,覆盖抖音、B站、小红书、公众号、X、播客等渠道。
支持图文内容保存、视频转文字以及字幕优先处理等功能,同时不依赖 GPU,适合构建个人知识库和内容素材库。
🔗 https://github.com/chubbyguan/chubbyskills
• social-media-copilot
简介:
开源社交媒体助手,主要面向小红书、抖音、快手等平台的数据采集,可通过 API 调用,并支持 Docker 部署。
🔗 https://github.com/iszhouhua/social-media-copilot
• XHS_Downloader_Chrome_Extension
简介:
针对小红书内容采集的浏览器插件,主要用于作品下载和素材备份,使用方式相对简单。
🔗 https://github.com/kongzhu2/XHS_Downloader_Chrome_Extension
• mcp-server-weibo
简介:
基于 MCP 的微博数据服务,可以用于获取微博用户信息、动态以及搜索相关内容,使 LLM 能够直接调用微博数据。
🔗 https://github.com/Selenium39/mcp-server-weibo
• stablog
简介:
用于微博记录备份与导出的工具,适合需要长期保存微博内容的场景。
🔗 https://github.com/YaoZeyuan/stablog
• Agent-Reach
简介:
面向 AI Agent 的多平台内容访问工具,可以帮助 Agent 获取和搜索 Twitter、Reddit、YouTube、GitHub、Bilibili、XiaoHongShu 等平台的信息。
通过 CLI 统一调用不同平台的数据访问能力,减少了分别对接不同平台的复杂度。
🔗 https://github.com/Panniantong/Agent-Reach
• last30days-skill-cn
简介:
针对中文互联网环境设计的 AI 研究工具,支持跨微博、知乎、B站等多个中国互联网平台进行信息采集,并对相关内容进行整理和排序。
• X AI Topic Selector
简介:
针对 X 平台收藏和列表内容设计的 AI Skill,主要提供扫描模式和书签模式。
扫描模式可以从指定列表中抓取内容并结合 AI 进行筛选;书签模式则用于分析收藏内容并生成整理报告,适合处理长期积累的大量信息。
🕷️ 三、通用网页爬虫与 LLM 数据提取
除了针对特定平台的采集工具,通用 Web Scraping 框架同样是内容采集体系中的重要组成部分。
这类工具通常具有更高的可定制性,可以根据目标网站、数据结构和业务流程设计采集规则,也更适合开发者和需要进行规模化数据处理的用户。
• crawl4ai
简介:
面向 LLM 场景设计的开源 Web 爬虫与抓取工具,重点解决 AI 应用中的网页内容获取和数据提取问题。
🔗 https://github.com/unclecode/crawl4ai
• Scrapling
简介:
自适应 Web Scraping 框架,可以覆盖从单次请求到大规模网页抓取的不同应用场景。
🔗 https://github.com/D4Vinci/Scrapling
• spider-flow
简介:
图形化爬虫平台,可以通过可视化方式定义爬虫流程,无需从零编写传统爬虫代码,适合希望降低开发门槛的用户。
🔗 https://github.com/ssssssss-team/spider-flow
• Flyscrape
简介:
面向不具备高级编程能力用户设计的命令行网页抓取工具,可以用于一些相对简单的网页采集任务。
🔗 https://github.com/philippta/flyscrape
• llm-scraper
简介:
利用 LLM 将网页内容转换为结构化数据,适合需要进行数据提取、清洗和格式化的场景。
🔗 https://github.com/mishushakov/llm-scraper
• ai-search4ai-go
简介:
使用 Go 开发的 AI 搜索代理服务,可以通过 API 让大型语言模型获取实时互联网信息,为 AI 应用增加联网搜索能力。
🔗 https://github.com/liyown/ai-search4ai-go
🤖 四、AI 联网、网页解析与智能剪藏
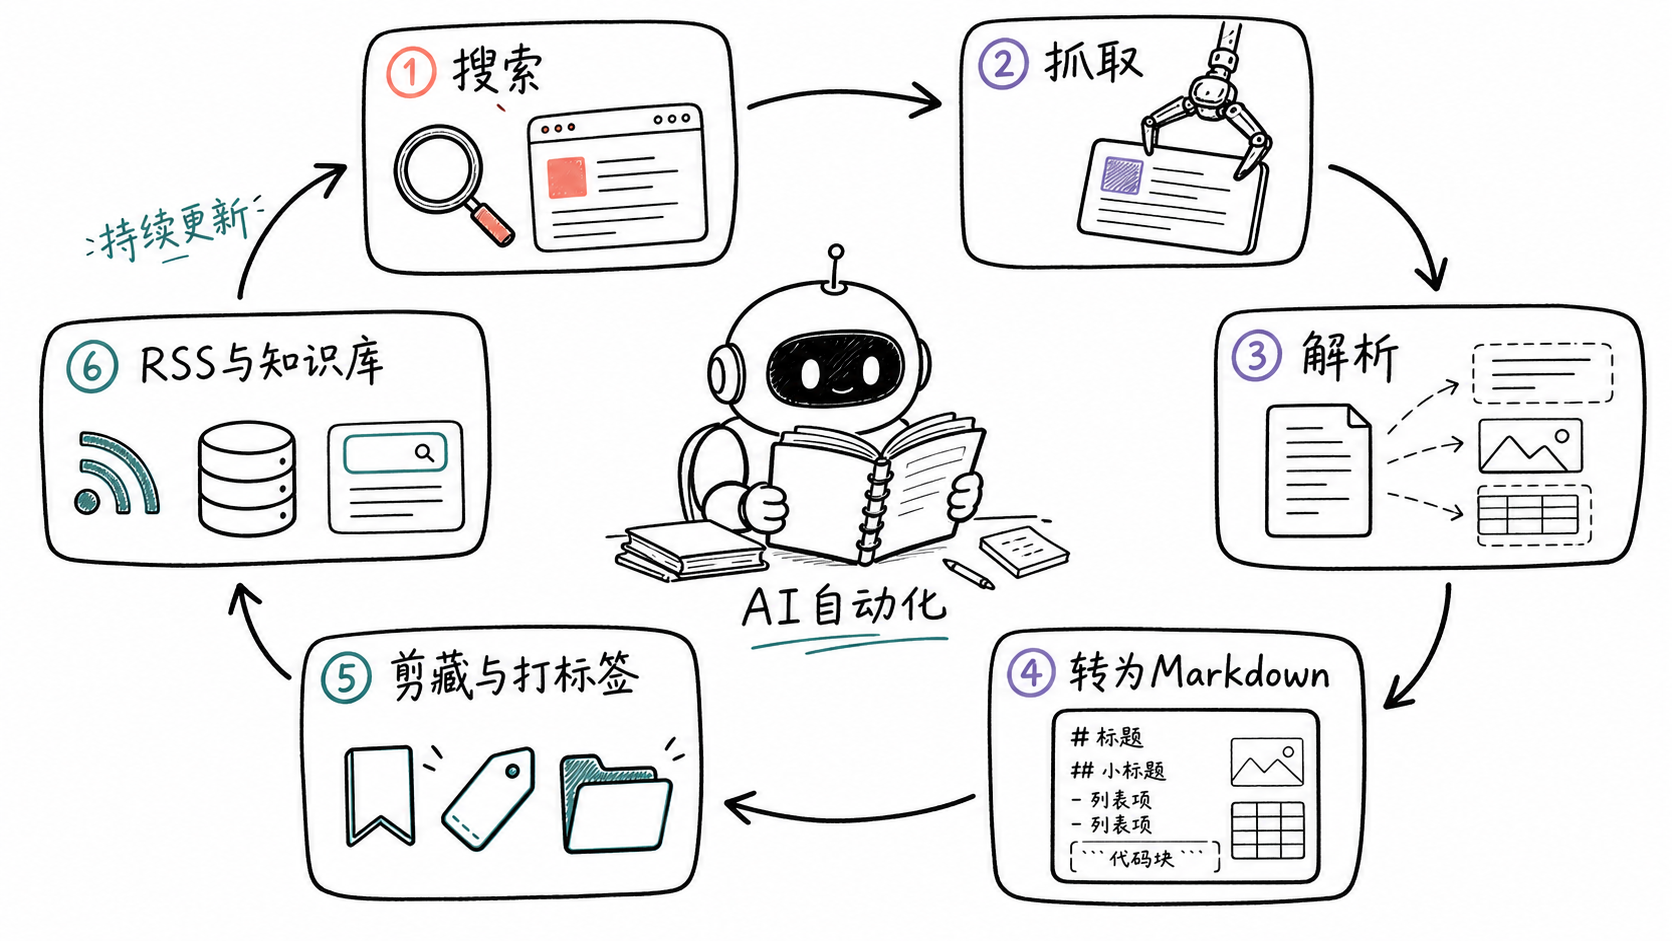
传统内容采集解决的是“如何获取信息”,而 AI Agent 的加入,则进一步解决了“获取之后如何处理信息”的问题。
网页解析、Markdown 转换、自动摘要、标签分类、知识沉淀等能力,可以组合成更加完整的信息处理工作流。
• firecrawl-mcp-server
简介:
Firecrawl 官方 MCP Server,为 Cursor、Claude 以及其他 LLM 客户端提供网页抓取和搜索能力,可以作为 AI Agent 获取互联网信息的基础设施。
🔗 https://github.com/firecrawl/firecrawl-mcp-server
• web-access
简介:
面向 Claude Code 的联网能力 Skill,通过多层通道调度、浏览器 CDP 以及并行分治策略,为 Agent 提供更完整的网页访问能力。
🔗 https://github.com/eze-is/web-access
• qiaomu-markdown-proxy
简介:
通过代理服务将 URL 转换为干净的 Markdown 内容,同时支持包括 X/Twitter 在内的一些需要登录才能访问的页面。
🔗 https://github.com/joeseesun/qiaomu-markdown-proxy
• x-reader
简介:
支持多个平台的通用内容阅读器 MCP Server,可以用于提取网页和文章正文,方便进一步交给 AI 进行分析和处理。
🔗 https://github.com/runesleo/x-reader
• maoxian-web-clipper
简介:
网页剪藏浏览器扩展,可以将网页内容保存到本地机器,降低网页内容失效后无法访问的风险,同时无需注册和付费。
🔗 https://github.com/mika-cn/maoxian-web-clipper
• content-collector-skill
简介:
用于构建 AI Agent 内容收藏工作流,可以自动完成网页读取、内容提炼、重点总结、分类、标签以及保存到飞书等操作,并支持定时提醒。
🔗 https://github.com/wuhongchen/content-collector-skill
• AutoContents
简介:
基于 RSS 的 AI 资讯聚合、内容创作与 Agent 自动化工具,可以将 RSS 信息源与 AI 内容处理能力结合起来。
🔗 https://github.com/comeonzhj/AutoContents
• Omnibox
简介:
集信息收集、整理、使用和分享于一体的综合型工具,适合建立统一的信息管理与素材处理流程。
🔗 https://github.com/import-ai/omnibox
• nebulapicker
简介:
自托管 RSS Feed 生成器,可以从经过筛选的外部信息源中提取内容,用于构建个性化的信息订阅体系。
🔗 https://github.com/djsilva99/nebulapicker
• 7deer_skills
简介:
开源 AI Agent 技能库,提供多个可复用的实战技能模块,覆盖数据采集、信息处理、外链建设等应用场景。
💡 核心选用指南
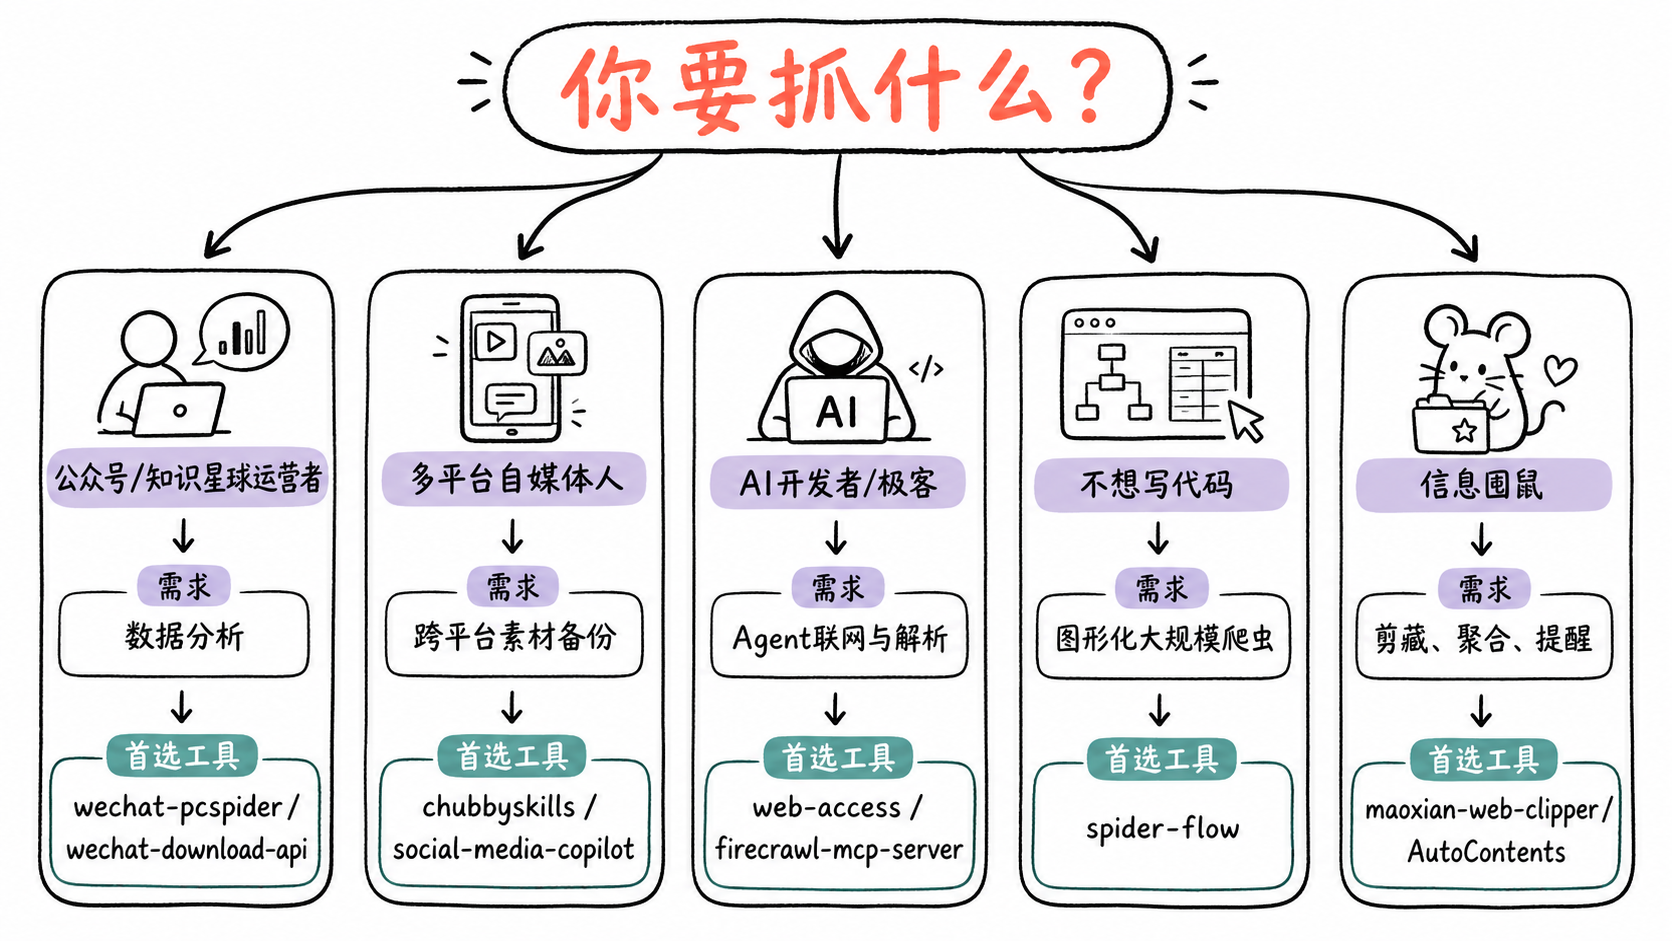
不同工具解决的问题并不完全相同。实际选择时,可以根据使用场景、技术能力以及数据规模进行区分。
1. 公众号 / 知识星球运营者
如果主要需求是公众号或知识星球内容采集,同时还需要分析阅读量、点赞量等数据,可以重点关注 wechat-pcspider 和 wechat-download-api。
如果希望进一步将采集到的文章直接整理到飞书或知识库,则可以结合 Hermes Agent 公众号抓取技能,构建从采集到知识沉淀的完整流程。
2. 多平台自媒体创作者
对于需要同时处理抖音、B站、小红书、公众号等多个平台素材的场景,chubbyskills 提供了较为完整的多平台 Skill 组合,可以覆盖图文提取、视频转文字等常见需求。
如果主要进行日常轻量级素材备份,也可以考虑使用 social-media-copilot 等浏览器工具。
3. AI 开发者与技术用户
如果核心需求是让 AI Agent 获取互联网信息,可以关注 web-access 和 firecrawl-mcp-server。
对于需要将网页内容转换为 Markdown 或提取正文的场景,qiaomu-markdown-proxy 和 x-reader 也可以作为内容解析层使用。
4. 大规模网页采集需求
对于需要搭建网页爬虫,但又希望降低开发门槛的场景,spider-flow 提供了图形化的流程配置方式。
对于具备一定开发能力、需要更高灵活性的用户,则可以进一步研究 crawl4ai 和 Scrapling 等现代 Web Scraping 框架。
5. 日常信息收藏与知识沉淀
如果主要需求是日常阅读、网页收藏和信息整理,可以使用 maoxian-web-clipper 进行本地剪藏,再结合 AutoContents 或 nebulapicker 构建 RSS 信息聚合。
在此基础上,再接入 content-collector-skill,可以进一步实现自动总结、分类、打标签和知识沉淀,从而将传统的“收藏夹”升级为更加自动化的信息处理系统。
写在最后
从微信公众号、知识星球,到小红书、抖音、B站、微博,再到通用网页和 AI Agent,内容采集工具正在从单纯的“网页抓取”逐渐发展成一套完整的信息处理基础设施。
过去,内容采集更多关注“能不能抓下来”;而在 AI 时代,关注点正在逐渐转向:
如何发现信息 → 如何获取信息 → 如何解析信息 → 如何理解信息 → 如何整理信息 → 如何沉淀为可复用的知识。
因此,这些开源项目并不一定需要单独使用。根据具体需求,将不同工具组合起来,往往可以构建出一套从信息发现、内容采集、AI 分析到知识沉淀的完整工作流。
对于开发者而言,这些项目也提供了大量可以直接研究和复用的开源方案,为构建自己的内容采集系统、AI Agent 或个人知识库提供了丰富的技术参考。
原文章:https://mp.weixin.qq.com/s/0bol2w0CwzUNhK2lOOFYaw